模块化与打包增强
本文目录
上级:Vite
现代前端项目中,文件是一个个模块组织的,代码相互导入的方式依赖于 esm 的模块化机制,而原始的模块化机制,对于现代的前端项目而言,又是能力不足的。
-
原生 ESM 的 import 很朴素
浏览器只认标准模块 URL,像 ./foo.js、/bar.js。它不知道 npm 包、资源文件、glob、worker 查询参数这些工程化语义。
-
bundler 会给 import 赋予额外语义
比如看到一条 import,不只是去加载模块,还可能:
- 把 npm 包解析出来
- 把图片拷贝到产物目录并返回最终 URL
- 把一组文件展开成多个导入
- 给 worker 单独产出 chunk
- 根据动态导入关系做 code splitting
**Vite 在开发时就某种程度上定义了 bundler 行为,**所以你一边享受原生 ESM 的快速按需加载,一边还能写 写面向打包器优化的代码 。
Vite 在 import 这一层定义和扩展了一些工程化语义;这些语义会在开发阶段被 dev server 解释,在生产阶段被 bundler 利用来完成解析、拆分、资源产出等行为。
因为打包,实际上是构建工具的一个环节,而打包器是构建工具一定含有的依赖,所以构建工具可以控制整个流程,通过定义一些语法,构建工具就可以解析他们,并且控制打包器的行为
注意,rolldown是打包器,而 pnpm 是包管理器
打包做什么事?—— 源码到运行产物的编译与重组。
- 理解依赖关系,它先从入口文件出发,分析 import / export,得到一张模块依赖图。
- 把源码变成目标环境能跑的东西,比如把 TS、JSX、Sass、PostCSS、较新的 JS 语法,转成浏览器或运行时能理解的格式。
- 重组文件结构
- 哪些代码放主包
- 哪些拆成异步 chunk
- 哪些资源单独输出
- 文件名怎么带 hash 方便缓存
- 删掉没用的东西,比如 tree-shaking、压缩、合并
放到 Vite 里理解:
- 开发阶段:更偏向“按需转换和按需提供模块”,尽量少提前处理
- 构建阶段:才真正完整地分析依赖图、优化、切 chunk、生成发布产物
- 模块化通常是打包的前提输入
- 打包器不是瞎拼文件,它是沿着模块依赖图工作的。
- 你模块边界越清晰,打包器越容易做 tree shaking、代码分割、公共 chunk 抽取。
- 打包是在利用模块化信息
- import 关系告诉打包器:哪些代码是同步依赖,哪些是异步依赖,哪些导出没被用到。
- 没有这些信息,优化能力会弱很多。
-
模块化解决的是开发层的问题
把代码拆成有边界的单元,每个模块只暴露需要暴露的东西,用 import/export 建立依赖关系。
-
打包解决的是运行和部署层的问题
读取这些模块之间的依赖图,然后把它们转换、重组、优化,产出浏览器或运行时更适合加载的文件。
ESM 增强,增强了什么?
- **模块解析增强,**浏览器原生 import 只认识相对/绝对 URL,不认识
import React from 'react'这种裸模块导入。Vite 会解析它、重写成浏览器可访问的 URL,并在开发时做依赖预构建。 - **模块兼容增强,**很多 npm 包不是原生 ESM,而是 CommonJS / UMD。Vite 会在开发阶段把这类依赖转成 ESM,让它们能进入浏览器模块体系。
- **模块热更新增强,**改一个组件,不需要整页刷新。Vite 基于模块边界做 HMR,只替换变更的模块,状态尽量不丢。
- **“万物皆模块”增强,**不只是
.js。ts、jsx、css、json、图片资源等,都可以通过 import 接进模块图里。例如:import data from './data.json',import './style.css' - **模块组织能力增强,**Vite 提供像 import.meta.glob 这种能力,能按文件系统 批量导入 模块。这对插件系统、路由自动收集、文章目录加载这类场景很有用。
- 构建期模块优化增强,到生产构建时,Vite 还会继续利用模块关系做代码分割、动态导入 chunk、预加载等优化。所以它不只是开发阶段“看起来更模块化”,而是开发和构建都围绕模块图工作。
以下是更细节的feature 和意图:
零配置
默认支持常见能力
- .ts、.tsx、.jsx 转译
- json 导入
- CSS / @import / url() 处理
- CSS Modules
- 静态资源导入(图片、字体、svg 等)
- HTML 入口和 HTML 里的资源处理
- import.meta.glob
- Web Worker 导入
- public 目录
- import.meta.env / vite/client 类型补充
npm 依赖解析和预构建
依赖的裸模块导入
仔细观察会发现,一般项目内的导入分为两类
-
项目内的源码文件,通常是相对路径或别名导入:
import axios from 'axios' import { ref } from 'vue' import clsx from 'clsx' -
通过包管理器安装的第三方依赖,通常是裸模块导入:
import axios from 'axios'
import { ref } from 'vue'
import clsx from 'clsx'
浏览器原生 ES 导入不支持下面这样的裸模块导入:import { someMethod } from 'my-dep' 上面的代码会在浏览器中抛出一个错误。
为什么需要裸模块导入?
包管理器,本质也是把远程的包下载到源码里使用,默认情况下,应该也是使用文件路径导入,如果不用裸模块导入,你可能得写成:
import { someMethod } from './node_modules/my-dep/dist/index.js'
这有几个问题:路径很长很具体,暴露了包内部目录结构,一旦包升级改目录,代码就全坏了,需要调整导入路径
- 具体的说,裸模块是一个模糊的路径,由构建工具解析这个模糊的路径,充当编译器或者翻译官的角色,这使得包内部的路径结构随意修改,外部源码也不用修改
- 此外,同一个包,在不同环境下可能需要不同实现,同样可以通过构建工具的中间层自动选择
- 浏览器版,Node 版,development 版,production 版,ESM 版,CJS 版
- 构建工具支持裸模块导入,不只是“能跑”,还因为这样更方便做优化,中间层使得构建工具有掌控权,可以做性能优化
总之,就是裸模块导入一方面可以简化路径,一方面通过引入构建工具的中间层,实现了两个层级的解耦,并且能够在中间层做通用的性能优化
实际项目里 node_modules 中的第三方包,绝大多数就是用裸模块导入。
这几乎就是现代前端工程化的默认方式;浏览器不直接支持,但 Vite、Webpack、Node 会负责把它解析掉。
Vite 如何处理
Vite 将会检测到所有被加载的源文件中的裸模块导入,并执行以下操作:
- 预构建 它们可以提高页面加载速度,并将 CommonJS / UMD 转换为 ESM 格式。预构建这一步由 Rolldown 执行,这使得 Vite 的冷启动时间比任何基于 JavaScript 的打包器都要快得多。
- 重写导入为合法的 URL,例如
/node_modules/.vite/deps/my-dep.js?v=f3sf2ebd以便浏览器能够正确导入它们。
依赖是强缓存的
Vite 通过 HTTP 头来缓存请求得到的依赖,所以如果你想要编辑或调试一个依赖,请按照 这里 的步骤操作。
和包管理器协作:Vite 主要从这几类信息里完成“找到包 + 决定怎么优化”的工作:
- package.json 的 dependencies/devDependencies 告诉它:项目依赖了哪些包;
- node_modules 告诉它:这些包在本地实际落在哪。Vite 扫到裸导入(如 import ‘vue’)后,会去这里找对应包。
- 锁文件(package-lock.json / pnpm-lock.yaml / yarn.lock)告诉它:当前安装的是哪一批确定版本,所以 Vite 可以把 .vite 里的预构建缓存和当前依赖版本绑定,版本变了就重算。
- vite.config.* 告诉它:哪些包要 include/exclude,别名怎么映射,条件导出用哪些 conditions,重复依赖怎么 dedupe。
- 额外信息如 symlink/monorepo 结构告诉它:某个依赖是不是本地联动包。不是从 node_modules 解析到的,Vite 往往会把它当源码处理,而不是当第三方依赖预构建。
依赖预构建过程
当你首次启动 vite 时,Vite 在本地加载你的站点之前预构建了项目依赖。默认情况下,它是自动且透明地完成的。这就是 Vite 执行时所做的“依赖预构建”。
依赖预构建,仅适用于开发模式。在开发时,Vite 走的是 “按需服务源码 + 浏览器原生 ESM”:浏览器请求哪个模块,Vite 就变换并返回哪个模块。
第三方依赖如果直接原样送给浏览器,常会有两个问题:
- 很多包是 CommonJS/UMD,浏览器原生 ESM 不能直接跑
- 很多包内部文件很多,浏览器会发出大量小请求,开发体验变慢
-
CommonJS 和 UMD 兼容性: 在开发阶段中,Vite 的开发服务器将所有代码视为原生 ES 模块。因此,Vite 必须先将以 CommonJS 或 UMD 形式提供的依赖项转换为 ES 模块。
在转换 CommonJS 依赖项时,Vite 会进行智能导入分析,这样即使模块的导出是动态分配的(例如 React),具名导入(named imports)也能正常工作:
import React, { useState } from 'react' -
性能: 为了提高后续页面的加载性能,Vite 将那些具有许多内部模块的 ESM 依赖项转换为单个模块。
有些包将它们的 ES 模块构建为许多单独的文件,彼此导入。例如,
lodash-es有超过 600 个内置模块!当我们执行import { debounce } from 'lodash-es'时,浏览器同时发出 600 多个 HTTP 请求!即使服务器能够轻松处理它们,但大量请求会导致浏览器端的网络拥塞,使页面加载变得明显缓慢。通过将lodash-es预构建成单个模块,现在我们只需要一个HTTP请求!
依赖搜寻是自动的过程,如上文所说,会扫描代码库,通常在 node module 里获取,使用 rolldown进行打包
依赖构建自定义配置
optimizeDeps 配置项 ,本质上就是为了控制和优化开发模式下的依赖处理,核心目标是开发体验,不是生产构建。
optimizeDeps 主要解决的是 dev server 启动和页面首次加载时,第三方依赖该怎么预构建。常见用途是:
- 提前 include 一些 Vite 没自动识别好的依赖
- exclude 不想预构建的依赖
- 处理 CJS、深层子路径导入、monorepo 联动包等特殊情况
- 减少冷启动和首次加载时的卡顿或重复扫描
有时候默认的依赖启发式算法(discovery heuristics)可能并不总是理想的。如果您想要明确地包含或排除依赖项,可以使用 optimizeDeps 配置项 来进行设置。
optimizeDeps.include 或 optimizeDeps.exclude 的一个典型使用场景,是当 Vite 在源码中无法直接发现 import 的时候。例如,import 可能是插件转换的结果。这意味着 Vite 无法在初始扫描时发现 import —— 只能在文件被浏览器请求并转换后才能发现。这将导致服务器在启动后立即重新打包。
如果依赖项很大(包含很多内部模块)或者是 CommonJS,那么你应该包含它;如果依赖项很小,并且已经是有效的 ESM,则可以排除它,让浏览器直接加载它。
你还可以使用 optimizeDeps.rolldownOptions 选项 进一步自定义 Rolldown。例如,添加 Rolldown 插件来处理依赖项中的特殊文件,或者更改 构建 target。
依赖预构建缓存
文件系统缓存
Vite 将预构建的依赖项缓存到 node_modules/.vite 中。它会基于以下几个来源来决定是否需要重新运行预构建步骤:
- 包管理器的锁文件内容,例如
package-lock.json,yarn.lock,pnpm-lock.yaml,或者bun.lock; - 补丁文件夹的修改时间;
vite.config.js中的相关字段;NODE_ENV的值。
只有在上述其中一项发生更改时,才需要重新运行预构建。
如果出于某些原因你想要强制 Vite 重新构建依赖项,你可以在启动开发服务器时指定 --force 选项,或手动删除 node_modules/.vite 缓存目录。
浏览器缓存
已预构建的依赖请求使用 HTTP 头 max-age=31536000, immutable 进行强缓存,以提高开发期间页面重新加载的性能。一旦被缓存,这些请求将永远不会再次访问开发服务器。如果安装了不同版本的依赖项(这反映在包管理器的 lockfile 中),则会通过附加版本查询自动失效。如果你想通过本地编辑来调试依赖项,您可以:
- 通过浏览器开发工具的 Network 选项卡暂时禁用缓存。
- 重启 Vite 开发服务器指定
-force选项,来重新构建依赖项。 - 重新载入页面。
Monorepo的本地包处理
-
monorepo 里本地包会被当成“源码依赖”,Vite 会尝试直接分析它,而不是打包
-
但前提是:它必须是 ESM,否则 Vite 不好处理
-
如果不是 ESM,就必须手动加入优化列表,optimizeDeps.include
-
修改本地包后可能需要清缓存重启,vite—force
模块热替换 HMR
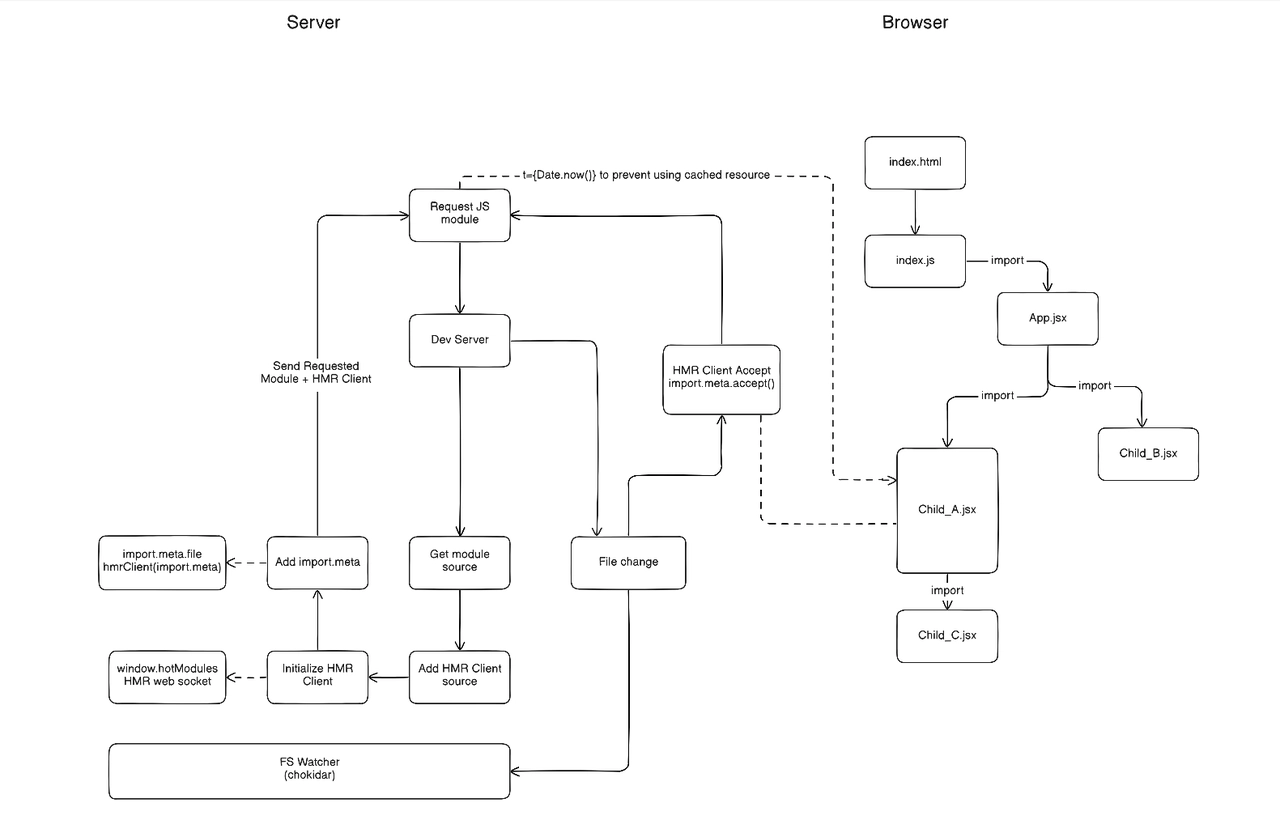
https://app.eraser.io/workspace/W1ZOWqpCPrv4Vz2vcytS
Typescript
Vite 天然支持引入 .ts 文件,不同于过去的 webpack 是零配置支持 ts能力的
Vite 仅执行 .ts 文件的转译工作,并不执行 任何类型检查。并假定类型检查已经被你的 IDE 或构建过程处理了。
也就是说它会把 TS 很快转成 JS 让项目跑起来,但不会默认替你做严格的类型报错拦截。
Vite 使用 Oxc 转换器 将 TypeScript 转译到 JavaScript,其速度比原生 tsc 更快
类型检查通常还是靠:tsc --noEmit 或者配合编辑器、插件来做。
tsc 是TypeScript 编译器,默认做两件事:
- 检查类型
- 把
.ts→.js
--noEmit 意味着不转译,只执行类型检查
Vite 之所以不把类型检查作为转换过程的一部分,是因为这两项工作在本质上是不同的。转译可以在每个文件的基础上进行,与 Vite 的按需编译模式完全吻合。相比之下,类型检查需要了解整个模块图。把类型检查塞进 Vite 的转换管道,将不可避免地损害 Vite 的速度优势。
Vite 的工作是尽可能快地将源模块转化为可以在浏览器中运行的形式。为此,我们建议将静态分析检查与 Vite 的转换管道分开。这一原则也适用于其他静态分析检查,例如 ESLint。
tsconfig
Vite 会参考 tsconfig.json 中的一些配置项,并设置相应的 Oxc 转换器选项。对于每个文件,Vite 会使用距离最近的父级目录中的 tsconfig.json。如果该 tsconfig.json 包含 references 字段,Vite 将使用满足 include 和 exclude 字段的被引用配置文件。
当选项同时在 Vite 配置和 tsconfig.json 中设置时,Vite 配置中的值优先。
tsconfig.json 中 compilerOptions 下的一些配置项需要特别注意。
- **
isolatedModules,**应该设置为true。你写的每个 TS 文件,都应该能单独安全地转译。- tsc会做全局分析再转译,Vite 转译:像“单科速改”,只看当前文件
- isolatedModules: true 就是在提前约束你,不要写那些“只有全局分析才成立”的代码。
target,tsconfig.target 不等于 Vite 的最终运行目标。- Vite 开发模式更倾向于少做转换,默认接近 esnext。
- 生产构建则看 build.target 之类的 Vite 配置。
path,写了路径别名"@/*": ["src/*"],这表示 TypeScript 类型系统认识 @/xxx 这种写法。- 但 Vite 不一定自动按这个跑。你需要显式告诉 Vite 去读 tsconfig.path
- 可以指定
resolve.tsconfigPaths: true来告诉 Vite 使用tsconfig.json中的paths选项来解析导入。 - 但这个功能有性能损耗,所以不建议这么设置
useDefineForClassFields,应该设置为 true,- 如果 TypeScript 的 target 是
ES2022或更高版本,包括ESNext,那么默认值将为true。这与 TypeScript 4.3.2 及以后版本的行为 保持一致。 若设了其他 TypeScript target,则本项会默认为false. - 如果你正在使用一个严重依赖 class fields 的库,请注意该库对此选项的预期设置。 虽然大多数库期望
"useDefineForClassFields": true,但如果你的库不支持它,你可以明确地将useDefineForClassFields设置为false。
- 如果 TypeScript 的 target 是
types: ["vite/client"],作用是让 TypeScript 认识 Vite 客户端环境里的额外能力- 导入图片、svg、css 之类资源
- 用 import.meta.env
- 用 import.meta.hot
Vite 默认的类型定义是写给它的 Node.js API 的。要将其补充到一个 Vite 应用的客户端代码环境中,你可以在 tsconfig.json 中的 compilerOptions.types 添加 vite/client
{
  "compilerOptions": {
    "types": ["vite/client", "some-other-global-lib"]
  }
}
需要注意的是,如果指定了 compilerOptions.types,则只有这些包会被包含在全局作用域内(而不是所有的“@types”包)。这是自 TypeScript 5.9 以来推荐的做法。
HTML 是资源入口
HTML 文件位于 Vite 项目的跟目录,作为应用程序的入口点,可轻松构建 SPA和 MPA。
Vite 把 HTML 当成应用入口,并把 HTML 中引用的资源纳入构建流程。
Webpack 的世界通常是:
- 从 main.js 开始
- 顺着 import 找到别的 JS
- JS 里再 import ’./style.css’
- 再通过 loader 处理图片、字体等资源
所以它主要是一个:**从 JS 模块图出发,递归收集依赖的打包器,**HTML 在这里通常不是模块图的起点。
Vite 将 index.html 视为源码和模块图的一部分。webpack只是把打包结果注入 HTML
在一个 Vite 项目中,index.html 在项目最外层而不是在 public 文件夹内。这是有意而为之的:在开发期间 Vite 是一个服务器,而 index.html 是该 Vite 项目的入口文件。
Vite 还能够处理依赖关系,解析处于根目录外的文件位置,这使得它即使在基于 monorepo 的方案中也十分有用。
Vite 的开发/构建流程,天然把 HTML 纳入了模块系统。 Vite dev server 本来就是按浏览器请求实时返回模块。因为“按浏览器请求实时返回模块”这件事,总得有第一个请求作为起点。对一个网页应用来说,这个起点通常就是 HTML。从 HTML 出发,浏览器请求什么,Vite 就处理什么,这和它的运行机制很一致。
Vite 把 HTML 当入口,本质上是在顺着浏览器天然的启动流程走。
**Vite 可以在最外层统一接管页面资源,**它不仅能看到 JS 入口,还能同时处理:
- HTML 里的模块脚本
- CSS 样式链接,图片、图标等资源路径
- 多页面入口
CSS 资源处理
导入 .css 文件将会把内容插入到 <style> 标签中,同时也带有 HMR 支持。
内联和变基
Vite 通过 postcss-import 预配置支持了 CSS @import 内联,Vite 的路径别名也遵从 CSS @import。换句话说,所有 CSS url() 引用,即使导入的文件在不同的目录中,也总是自动变基,以确保正确性。
**@import 内联,**Vite 在处理时把被导入文件内容直接展开进来,不用再次发请求
比如你写:
/* src/styles/main.css */
@import './base/reset.css';

body {
  color: #222;
}
/* reset.css 的内容先插进来 */
/* 然后再接 main.css 自己的内容 */
Vite 处理时,会把 reset.css 的内容当成 main.css 的一部分来处理。这就叫 内联,也就是简单保留一个原始 @import 让浏览器自己再去加载。
如果 Vite 把 reset.css 内联进 main.css,文件“所在位置”就变了。如果路径不调整,url(’../../images/bg.png’) 可能就会指错地方。
假设目录如下,reset.css 里写:background: url('../../images/bg.png'); ,不变路径就会报错,这就是变基
src/
  styles/
    main.css
    base/
      reset.css
  images/
    bg.png
PostCSS 转译 和 CSS 语法增强
Vite 在生产构建中默认使用 Lightning CSS 来压缩 CSS,但 PostCSS 仍用于其他 CSS 处理。
同样也有对完全使用 Lightning CSS 进行 CSS 处理的实验性支持。你可以通过添加 css.transformer: 'lightningcss' 来选择启用它。
如果项目包含有效的 PostCSS 配置 (任何受 postcss-load-config 支持的格式,例如 postcss.config.js),它将会自动应用于所有已导入的 CSS。
请注意,CSS 最小化压缩将在 PostCSS 之后运行,并会使用 build.cssTarget 选项。
PostCSS 本质上是一个“CSS 处理平台 / 编译管线”。很多你以为是“CSS 新语法支持”的功能,其实都是 PostCSS 插件完成的。
它本身不是某一个具体功能,而是:
- 负责解析 CSS → 生成 AST(抽象语法树)
- 允许插件修改 AST
- 再输出新的 CSS
所以它更像:
Babel 之于 JavaScript
=
PostCSS 之于 CSS
Vite 也同时提供了对 .scss,.sass,.less,.styl 和 .stylus 文件的内置支持。没有必要为它们安装特定的 Vite 插件,只须安装相应的预处理器依赖
这些都是 CSS 的语法增强预处理器,步骤:写一种更强的 CSS→ 编译→ 生成普通 CSS
如果使用的是单文件组件,可以通过 <style lang="sass">(或其他预处理器)自动开启。
禁用CSS
可以禁用 CSS 注入页面,使用?inline导入:
import './foo.css' // 样式将会注入页面
import otherStyles from './bar.css?inline' // 样式不会注入页面
静态资源处理
Vite 怎么把各种静态资源当成可导入的模块来处理。
核心规则是:
- 直接 import ’./img.png’,拿到的是一个 URL
- CSS 里的 url(…) 也会被同样处理
- 常见图片、字体、媒体、SVG 会自动识别
- 小资源会被内联成 base64
- 大资源会作为独立文件输出并带 hash
另外还有几个常用方式:
- ?url:强制按 URL 导入
- ?inline / ?no-inline:控制是否内联
- ?raw:按字符串导入
- ?worker / ?sharedworker:把脚本当 Worker 导入
- public 目录:放不参与打包、但要原样保留的资源
- new URL(’./img.png’, import.meta.url):用原生 ESM 方式拿资源 URL,生产构建时 Vite 会帮你改写
构建优化
导入
global导入
import.meta.glob 是“按文件模式批量导入”的语法糖,主要用来减少手写导入和做自动化加载。
常见用途:
- 批量加载一目录下的模块
- 做路由自动注册
- 批量读取 Markdown、JSON、图片
- 批量收集测试文件、插件、页面组件
Vite 这里的“匹配模式”就是 glob 通配符,常用的是这些:
./dir/*.js:只匹配这一层的.js./dir/**/*.js:匹配子目录,**代表递归./dir/?.js:匹配单个字符./dir/*.{js,ts}:匹配多后缀,花括号展开['./dir/*.js', './other/*.js']:多个匹配模式['./dir/*.js', '!**/bar.js']:排除模式,!开头
动态导入
Vite 也支持带变量的动态导入。
const module = await import(`./dir/${file}.js`)注意变量仅代表一层深的文件名。如果 file 是 foo/bar,导入将会失败。对于更进阶的使用详情,你可以使用 glob 导入 功能。
另请注意,动态导入必须符合以下规则才能被打包:
- 导入语句必须以
./或../开头:
import(`./dir/${foo}.js`) // valid
import(`${foo}.js`) // invalid- 导入语句必须以文件扩展名结尾:
import(`./dir/${foo}.js`) // valid
import(`./dir/${foo}`) // invalid- 导入到自身目录时,必须指定文件名模式:
import(`./prefix-${foo}.js`) // valid
import(`./${foo}.js`) // invalid这些规则旨在防止意外导入不应打包的文件。例如,如果没有这些规则,import(foo) 会将文件系统中的所有内容都打包。
wasm和 webworker 的导入
浏览器原生可以这样写:
const worker = new Worker('/worker.js')
wasm和 worker 这样类似的写法都没问题。但在工程化项目里会马上碰到路径和模块化问题。因为这么写它不会被纳入依赖图之中
Vite 支持把 .wasm 和 web worker的导入,自动处理相关的问题
浏览器原生能力解决的是:
- Worker 可以开线程
- Wasm 可以执行二进制模块
Vite 解决的是:
- 这些文件怎么进入项目依赖体系
- 路径怎么在 dev/build 间保持正确
- 打包后怎么还能找到它们
- 怎么用更统一的模块方式引用它们
杂项能力
Liscence,Vite 可以通过 build.license 选项生成一个包含构建中使用的所有依赖项许可证的文件。该文件可以被托管,用于显示和确认应用程序所使用的依赖项。
CSP**内容安全策略,**由于 Vite 的内部机制,为了部署 CSP 必须设置某些指令或配置。